
21
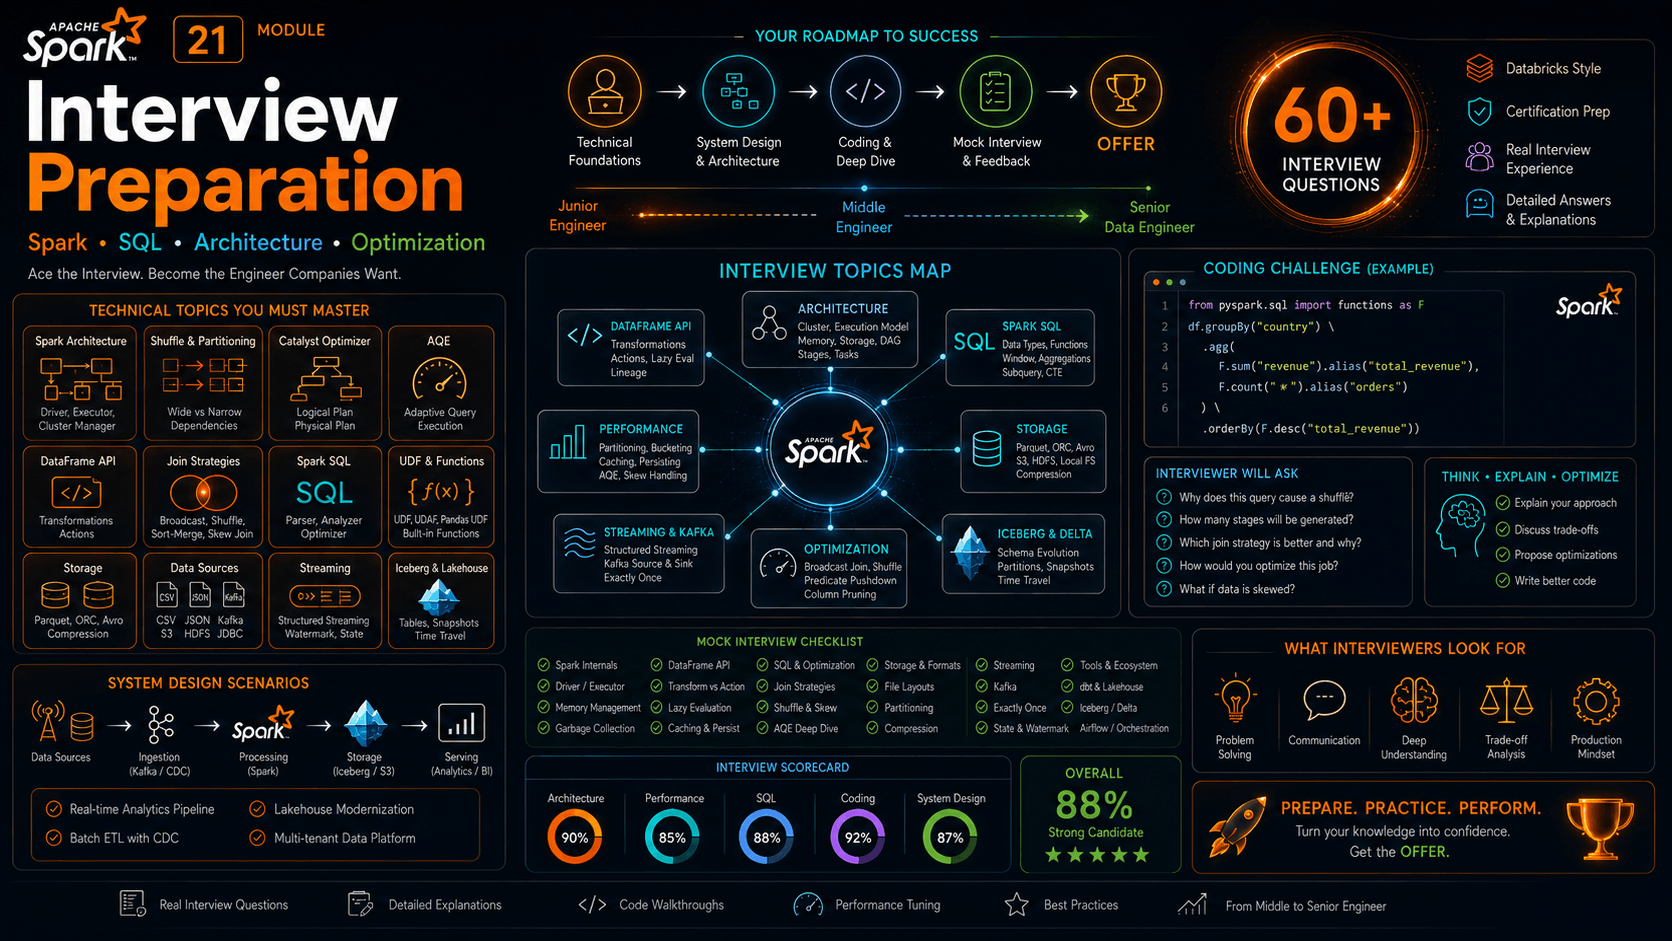
Подготовка к собеседованию
175+ вопросов с ответами: архитектура, оптимизация, DataFrame API, Python-расширения, разборы кейсов, S3/HDFS/Iceberg, Kafka и мониторинг.
core
interview
Контрольные задания
✓
Ответить устно на все вопросы Блока 1 без подсказок
✓
Написать top-3 salary per department с Window и без него
✓
Объяснить своими словами что произойдёт при 1 TB × 1 TB join
✓
Объяснить разницу CoW и MoR и выбрать режим для CDC-пайплайна
✓
Описать структуру метаданных Iceberg от Catalog до Data Files
✓
Объяснить иерархию Kafka: Cluster → Broker → Topic → Partition → Segment
✓
Назвать 5 методов доставки Python-зависимостей в Spark
✓
Пройти Блок 8 без ошибок: ответить на все 70 практических вопросов
Уроки модуля
1
Блок 1 - Архитектура и основы
2
Блок 2 - Оптимизация и производительность
3
Блок 3 - DataFrame API и SQL
4
Блок 4 - Python и расширенные возможности
5
Блок 5 - Практические кейсы
6
Блок 6 - S3, HDFS и Apache Iceberg
7
Блок 7 - Kafka, Streaming и мониторинг
8
Блок 8 - Практические вопросы
9
101 практическое упражнение по PySpark