
01
Spark Internals
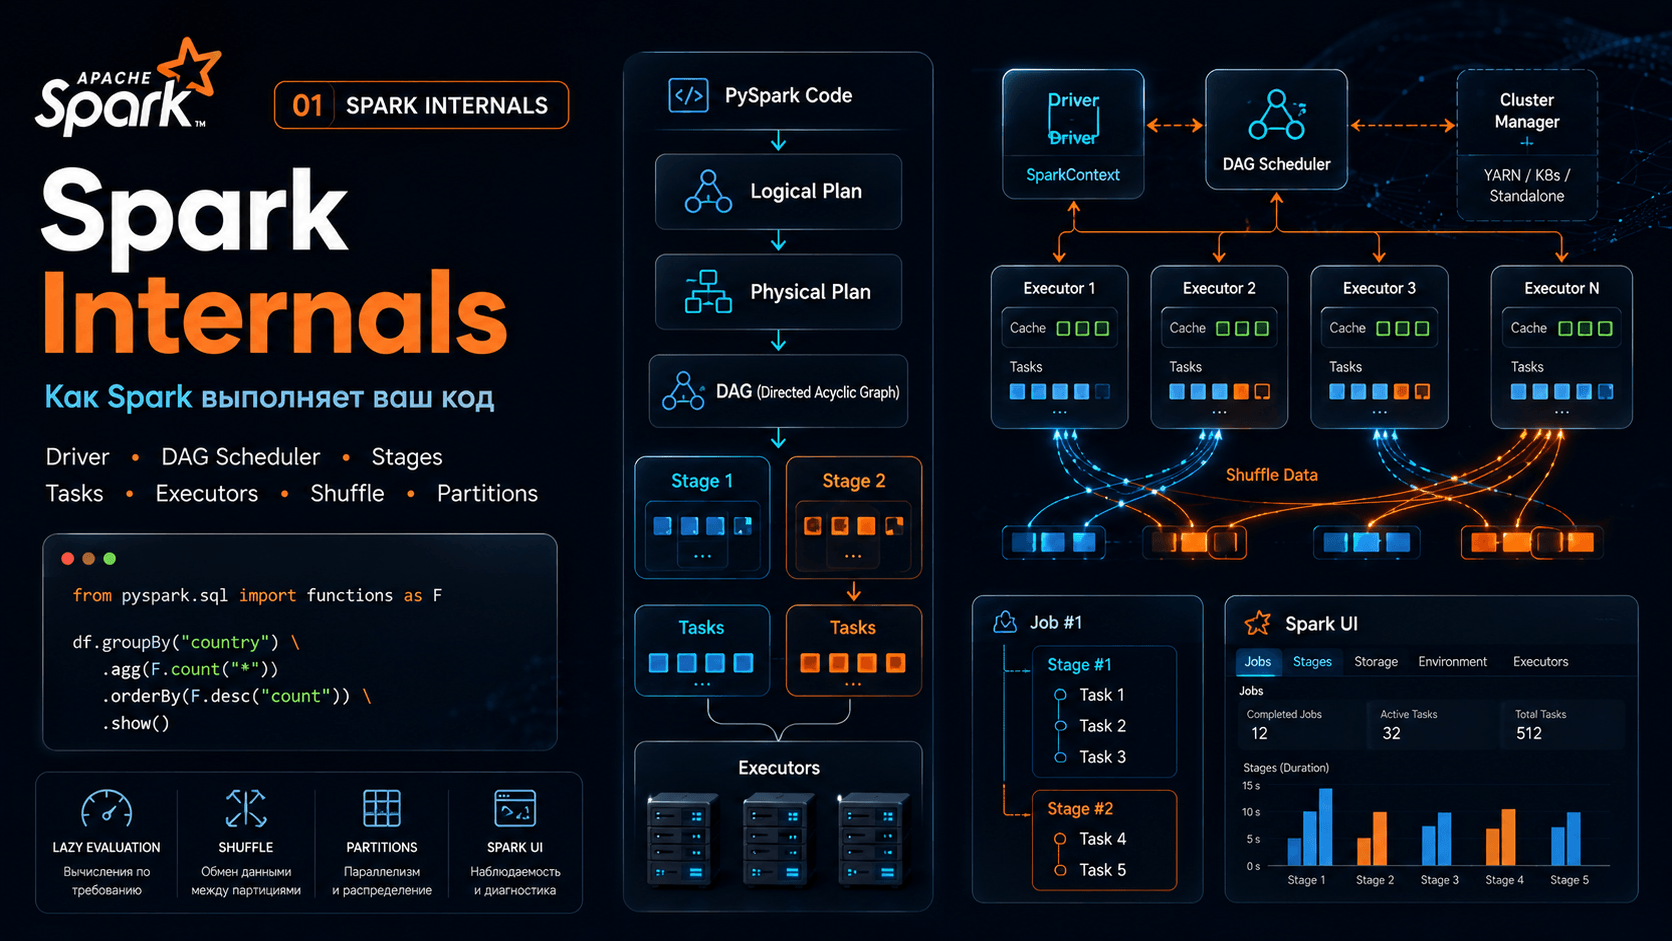
DAG, Catalyst, Tungsten и memory model - язык диагностики всех performance-проблем.
core
optimization
Контрольные задания
✓
Найти Exchange в плане запроса
✓
Собрать статистики таблицы через ANALYZE
✓
Объяснить spill и GC pressure
Уроки модуля
1
DAG Scheduler: как трансформации превращаются в задачи
2
Stage Boundary: почему shuffle создаёт новый Stage
3
Task Scheduling: FIFO vs FAIR, locality levels
4
Catalyst Optimizer: 4 фазы от AST до Physical Plan
5
Rule-Based Optimization: constant folding, predicate pushdown, column pruning
6
Cost-Based Optimizer: ANALYZE TABLE и статистика колонок
7
Tungsten: UnsafeRow, off-heap память и Whole-Stage CodeGen
8
Unified Memory Model: execution vs storage регионы и граница
9
Spill на диск: причины, диагностика в Spark UI и как избежать
10
GC Pressure: G1GC настройки, off-heap память и сигналы в логах
11
Py4J Gateway и Python Workers: как Python-код переходит в JVM
12
Data Locality: перемести код к данным, а не данные к коду
13
Жизненный цикл Spark-приложения: от SparkContext до Block Manager
14
Speculative Execution: straggler detection и когда отключать
15
Spark Connect: gRPC thin client и удалённое подключение без локального Spark