
06
HDFS
HDFS для on-prem кластеров: NameNode HA, locality, erasure coding, Hive Metastore и интеграция со Spark.
storage
platform
Контрольные задания
✓
Найти мелкие файлы через hdfs dfs -du
✓
Проверить блоки через fsck
✓
Объяснить отличие HDFS от S3
✓
Подключить Spark к Hive Metastore через enableHiveSupport()
✓
Создать External Table с LOCATION и проверить DROP TABLE поведение
✓
Настроить Dynamic Partition Overwrite для идемпотентного DAG
Уроки модуля
1
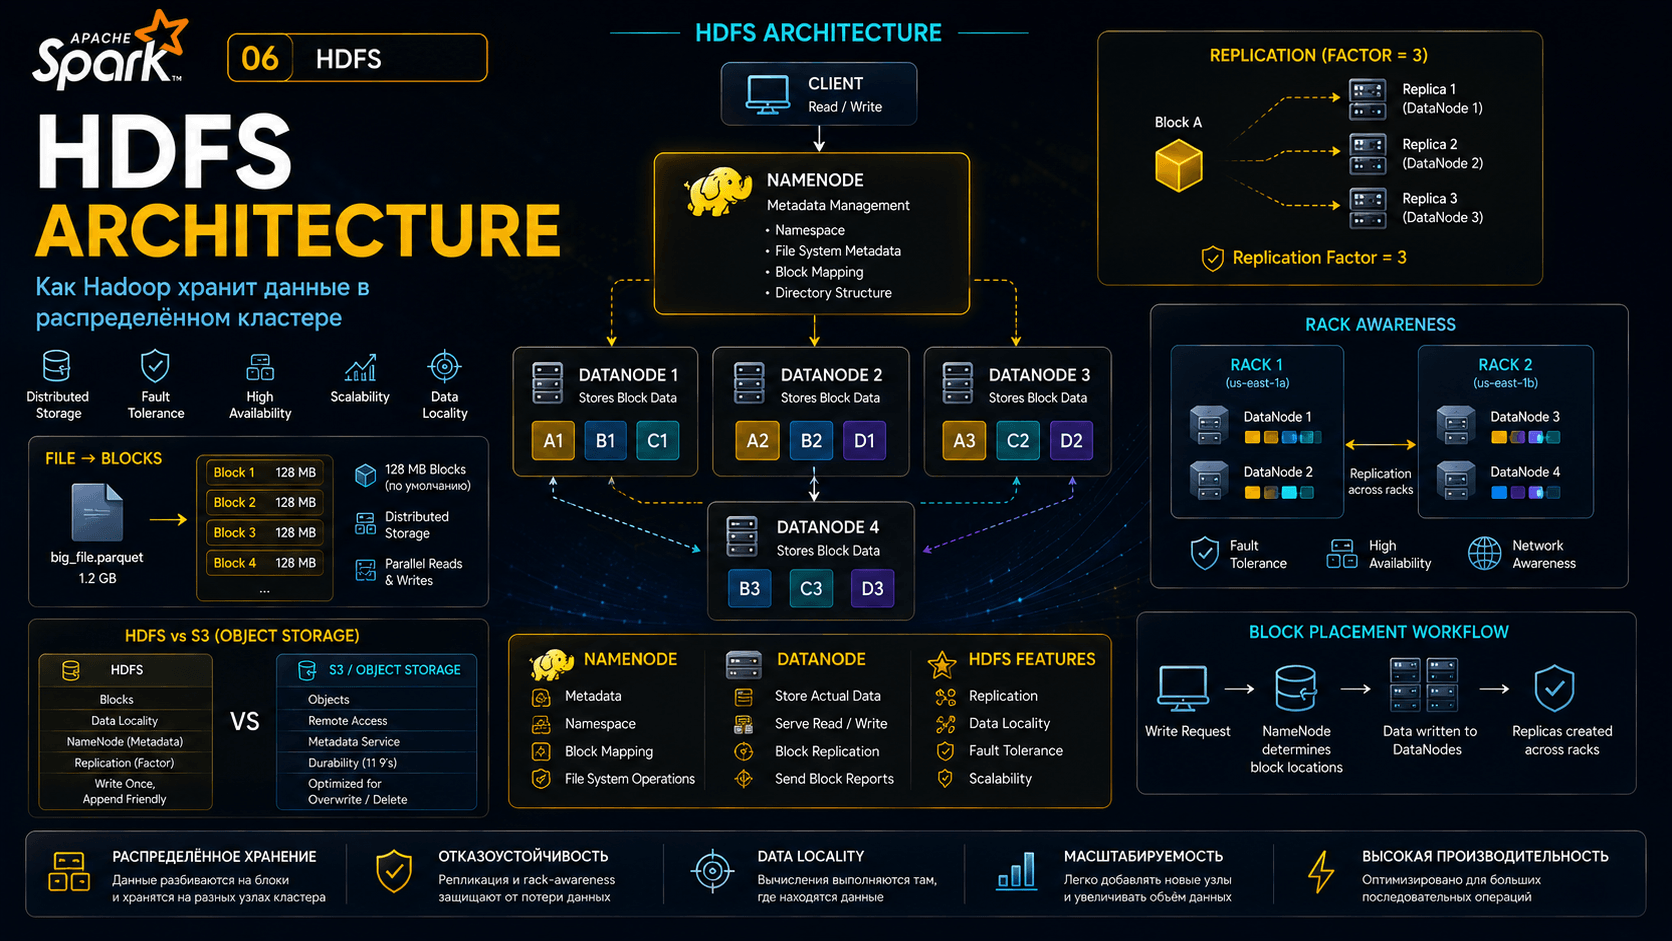
HDFS Architecture: NameNode, DataNode, блоки, репликация и heartbeat
2
NameNode HA: QJM quorum, Standby NameNode и автоматический failover
3
Block Locality: как Spark scheduler использует data-locality при планировании
4
Short-Circuit Reads: чтение DataNode без сетевого стека через Unix socket
5
Erasure Coding: Reed-Solomon коды, overhead vs репликация, hot/cold данные
6
Small Files в HDFS: нагрузка на NameNode heap и метаданные
7
HDFS CLI: диагностика через hdfs dfs, fsck, dfsadmin и балансировка
8
HDFS vs S3: когда что выбирать - latency, consistency, стоимость
9
Hive Metastore: HMS как Thrift-сервер метаданных, enableHiveSupport() и spark.catalog API
10
Managed vs External Tables: lifecycle данных, LOCATION, DROP TABLE поведение и Data Lake паттерн
11
Dynamic Partition Overwrite: partitionOverwriteMode=dynamic - идемпотентная перезапись разделов
12
Форматы файлов в HDFS: ORC vs Parquet vs Avro, Snappy vs ZSTD vs Gzip - когда что выбирать
13
Hive DDL: STORED AS, ROW FORMAT SERDE, MSCK REPAIR TABLE и StorageDescriptor в метасторе