
02
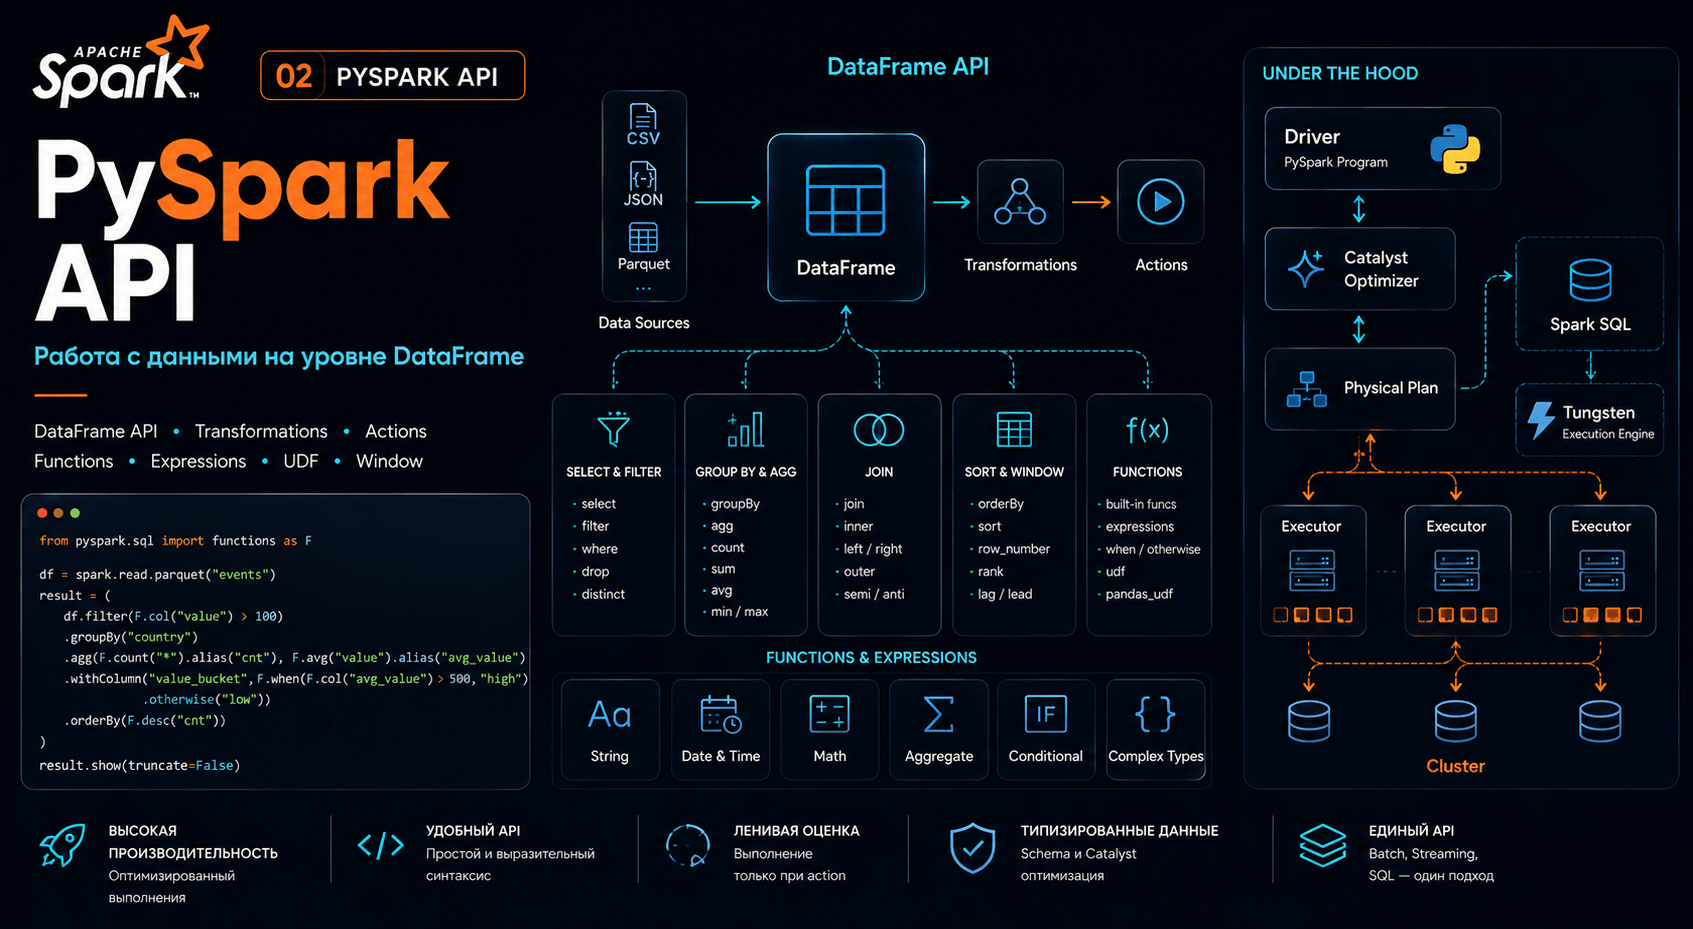
Продвинутый PySpark API
Column expressions, built-in functions, complex types, windows, joins, pandas UDF и паттерны работы с данными.
core
Контрольные задания
✓
Решить dedup latest row с Window row_number
✓
Сделать sessionization по событиям
✓
Переписать Python UDF на functions.* (string + date)
✓
Написать foreachPartition для записи в JDBC без пересоздания соединений
Уроки модуля
1
DataFrame API: select, filter, withColumn, alias и Column expressions
2
Агрегации: groupBy, agg, rollup, cube и grouping sets
3
Window Functions: frame specification, ROWS vs RANGE, UNBOUNDED
4
Window Functions Advanced: сложные примеры в DWH и Data Lake
5
String Functions: Spark SQL против Python UDF
6
Date/Time Functions: от строк до таймзон
7
Conditional Columns: when/otherwise, coalesce, nullif и NULL-безопасные сравнения
8
sample() и randomSplit(): стратифицированная выборка и train/test split
9
Complex Types: работа с ArrayType, MapType и функциями higher-order
10
StructType: вложенные схемы, schema inference и schema evolution
11
UDF: Python UDF и их цена - когда стоит, когда не стоит
12
Pandas UDF (Arrow): SCALAR, GROUPED_MAP, GROUPED_AGG
13
Join стратегии: broadcast, sort-merge, shuffle hash и join hints
14
Форматы данных: Parquet, ORC, Avro - выбор, настройка, pushdown
15
Контроль Ingestion: inferSchema, режимы чтения и изоляция брака
16
Actions в деталях: foreachPartition, checkpoint для длинных DAG, toPandas safety
17
Тестирование PySpark: от хаоса к надёжности
18
Pandas API on Spark (pyspark.pandas): когда и как
19
DataFrame Wrangling: filtering joins, set operations и wide↔long