
20
Native Execution Engines
Ускорение PySpark без изменения кода: SIMD, Arrow, Comet, Velox/Gluten, RAPIDS, Photon, Serverless K8s и Ray.
optimization
platform
engines
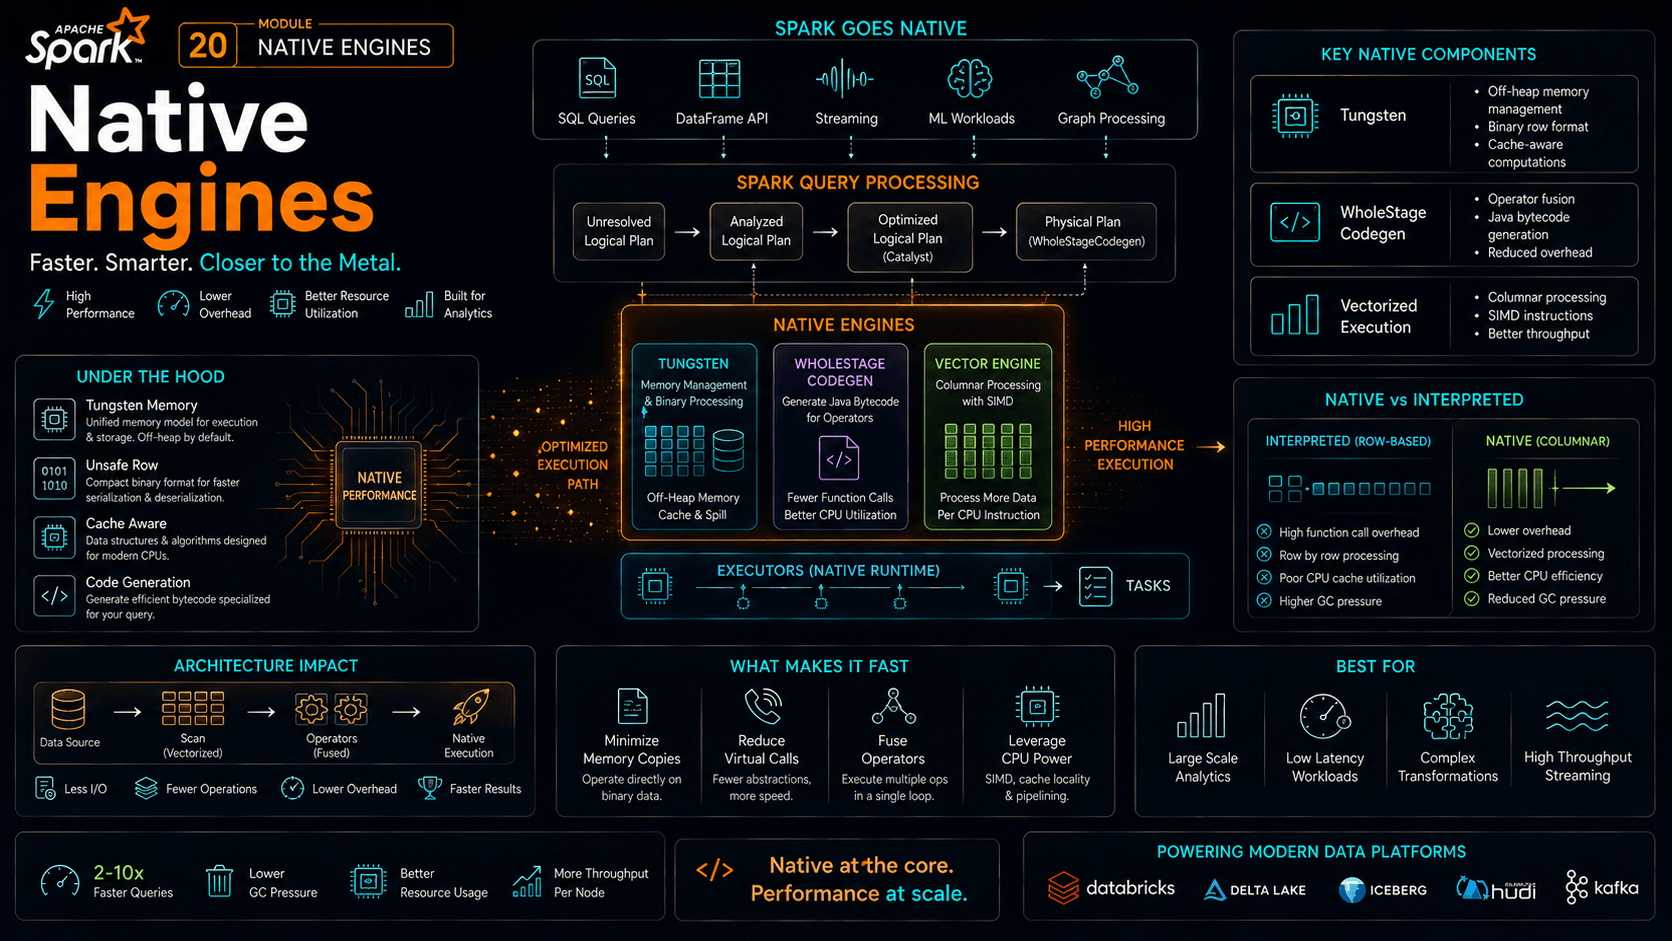
Контрольные задания
✓
Объяснить, почему SIMD не работает в стандартном Spark и как это решает Comet/Velox
✓
Включить Comet и запустить TPC-H бенчмарк
✓
Написать Pandas UDF с @pandas_udf и объяснить роль Arrow в передаче батчей
✓
Выбрать движок по матрице для своего кейса
✓
Запустить Sail и подключиться через SparkSession.builder.remote()
Уроки модуля
1
Проблема JVM: почему Tungsten не может использовать SIMD и при чём тут колоночное хранение
2
SIMD и векторные регистры: AVX-512, как процессор обрабатывает Parquet-колонку пачкой за один такт
3
Apache Arrow: in-memory columnar format, zero-copy передача и Record Batch как граница Python ↔ JVM ↔ C++
4
Pandas UDF с Arrow: @pandas_udf, Series-батч вместо строки, скорость vs Row-at-a-time UDF
5
Spark Plugin API: SparkPlugin и QueryStage интерфейс для замены executor
6
Photon (Databricks): SIMD-движок на C++, что заменяет в Tungsten, 3–10× на Join и агрегациях
7
Apache DataFusion Comet: архитектура Rust + Arrow, как подключается к Spark
8
Comet: установка, операторы, ограничения и TPC-H бенчмарк
9
Gluten + Velox: Substrait IR и offloading вычислений в C++ Velox
10
RAPIDS cuDF: GPU acceleration, CUDA требования и профиль данных
11
RAPIDS: когда GPU не даёт прироста - малые данные, IO-bound запросы
12
Serverless Spark на K8s: EMR Serverless, Dataproc Serverless, pod templates и auto-scaling
13
Ray + RayDP: Spark ETL → Ray Actor для distributed ML, сравнение с MLlib
14
Выбор движка: Comet vs Velox vs RAPIDS vs Photon - матрица по кейсам
15
Sail: Rust-нативный движок с полным Spark API