
07
Optimization
Skew, AQE, memory sizing, join strategies - инженерный подход.
optimization
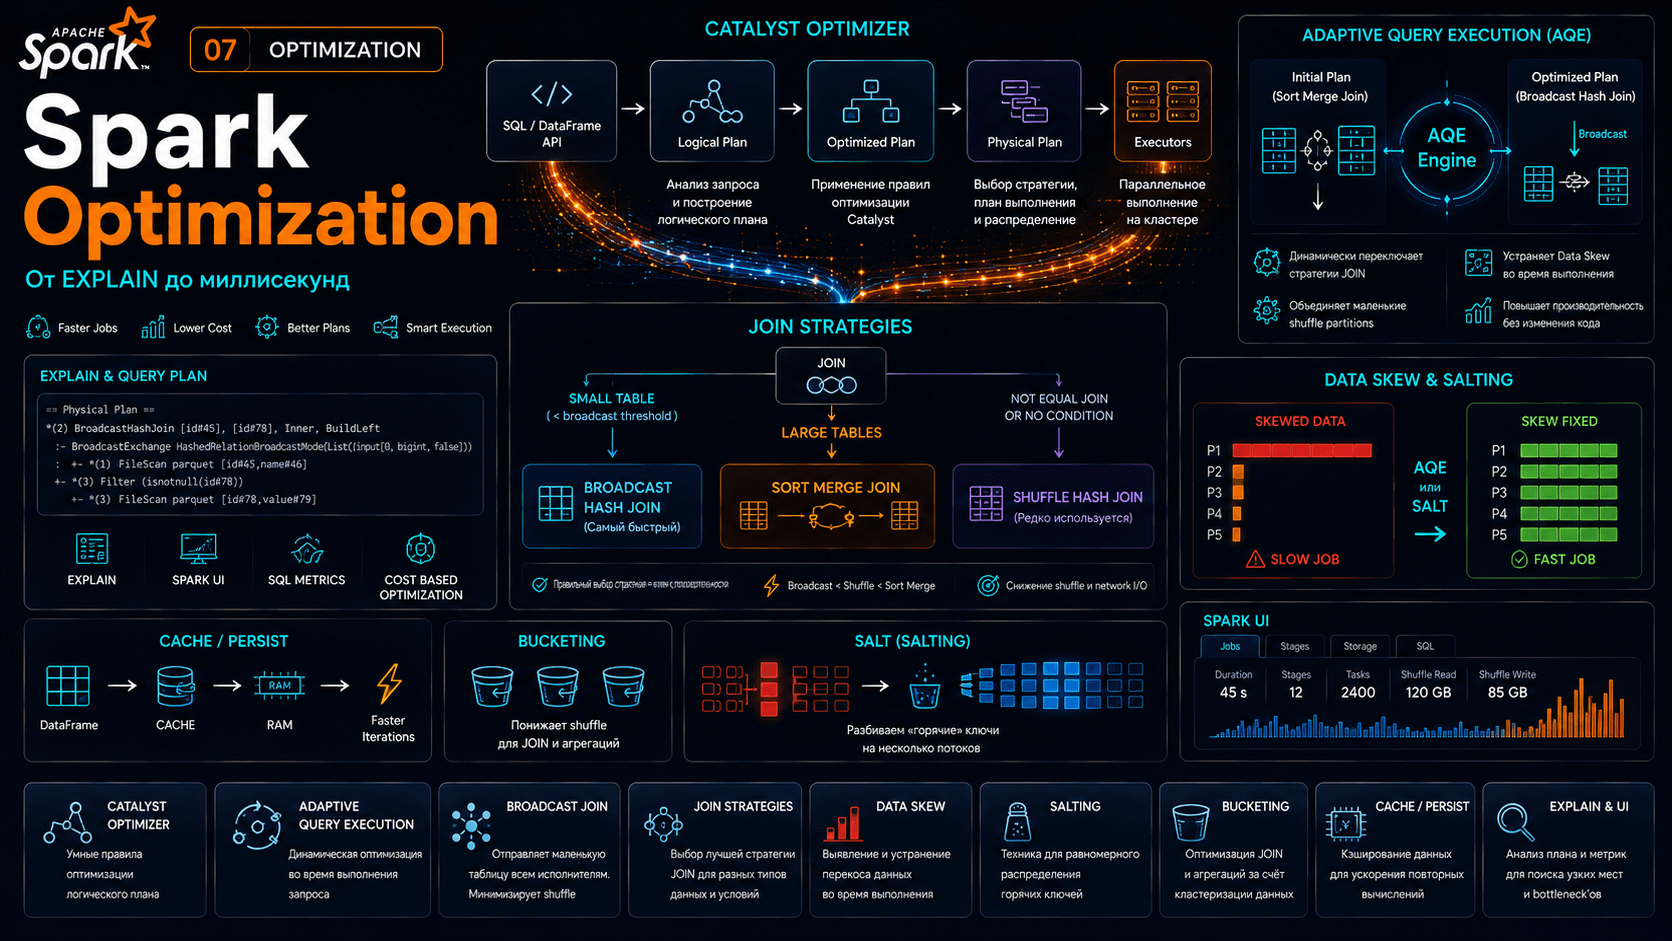
Контрольные задания
✓
Ускорить skewed join через salting
✓
Сравнить broadcast и sort-merge join
✓
Рассчитать executor memory по формуле
Уроки модуля
1
Spark UI: рентген вашего приложения
2
Skew Detection: как увидеть skew в Task Duration и shuffle read
3
AQE: Adaptive Query Execution - включение, параметры и что оно реально делает
4
AQE Skew Join: автоматическое обнаружение и разбиение hot partitions
5
Data Skew: ручной salting - генерация ключей и двухпроходная агрегация
6
Executor Sizing: 4-компонентная формула памяти и правило 5 cores
7
Memory Fractions: spark.memory.fraction, storageFraction и tuning
8
Broadcast Join: autoBroadcastJoinThreshold, hints и Task Too Large
9
Sort-Merge Join vs Shuffle Hash Join — когда каждый применяется
10
KryoSerializer: регистрация классов и измеримый выигрыш
11
mapPartitions: connection pool паттерн для JDBC и HTTP клиентов
12
Bloom Filter Join и Dataset vs RDD — узкоспециализированные случаи
13
Кэширование: cache(), persist() и управление памятью
14
Все 5 стратегий JOIN: физика алгоритмов и управление Catalyst
15
Hardware Tuning: spark.local.dir на NVMe и memoryOverhead для Python
16
Runtime Filtering: AQE Bloom Filter push к сканированию и dynamic filtering в Star-Schema joins